ForgeLM

Inferência local de LLMs .gguf em Rust: API no estilo OpenAI, CLI e app desktop Tauri, tudo na sua máquina.

Quickstart · Arquitetura · Documentação · Issues ![Stack](https://img.shields.io/badge/Stack-Rust%20%2B%20Tauri%202-dea584?logo=rust&logoColor=white) ![Status](https://img.shields.io/badge/status-em%20desenvolvimento-yellow) ![Licença](https://img.shields.io/badge/licen%C3%A7a-MIT-blue)
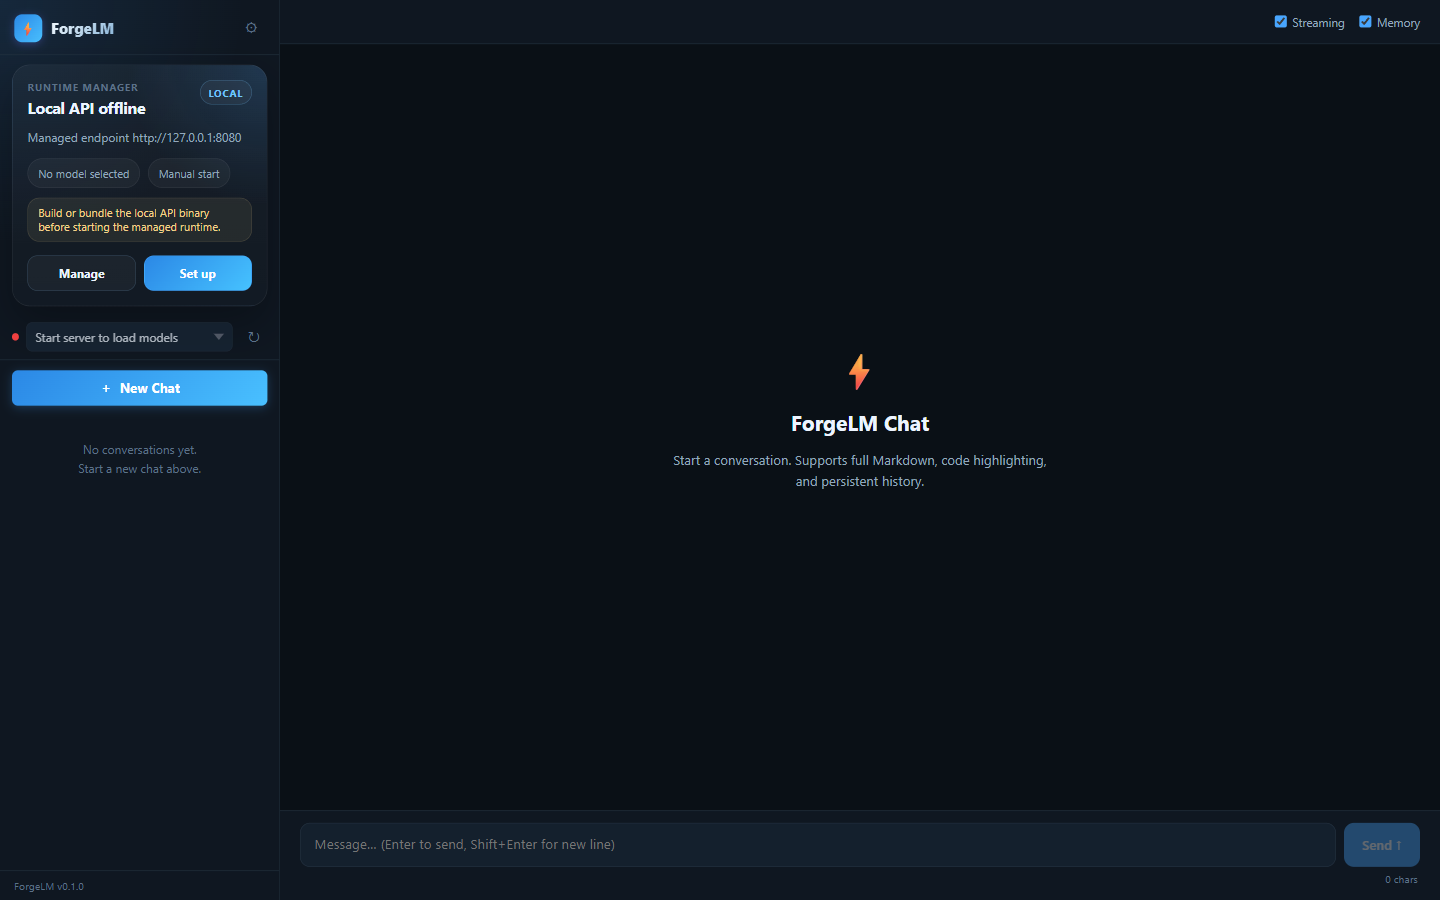
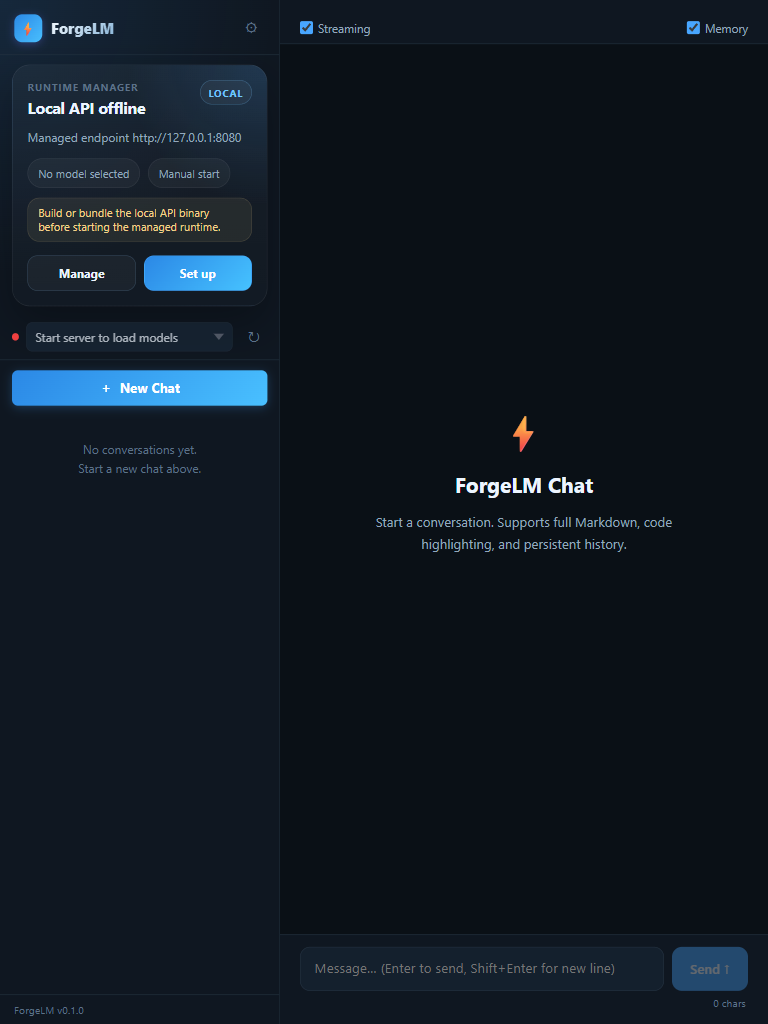
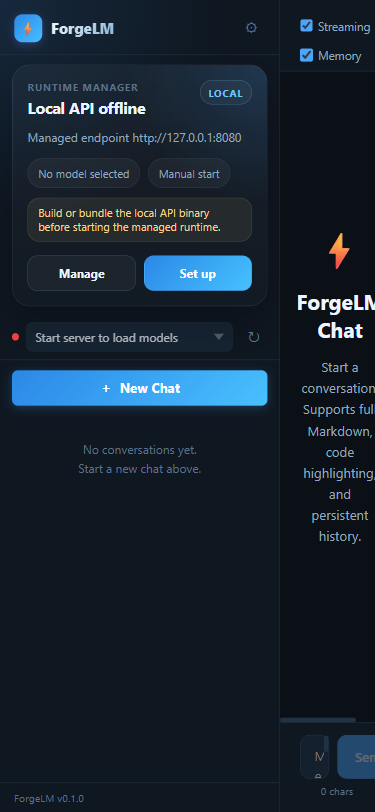
> [!NOTE] > **Este projeto não está concluído.** O que está descrito abaixo é o que existe hoje no código. Segundo [`.planning/ROADMAP.md`](.planning/ROADMAP.md), as fases 1–4 estão concluídas; a fase 5 (validação de fontes de modelo) segue aberta no roadmap e a fase 6 (redesign do chat) consta como planejada. ## 📌 O problema Rodar um modelo `.gguf` na própria máquina exige juntar peças soltas: um runtime do llama.cpp compatível com a sua GPU, uma API que clientes no estilo OpenAI consigam chamar e um lugar para escolher modelos e conversar. O ForgeLM reúne essas peças em um workspace Rust local-first, sem depender de infraestrutura hospedada, e documenta o que ainda não funciona. ## ✨ O que faz (o que existe hoje) - **Serve** `GET /health`, `GET /v1/models` e `POST /v1/chat/completions` em `:8080`, com streaming SSE e `stream_options.include_usage`. - **Carrega** modelos `.gguf` via llama.cpp (carga dinâmica) com os perfis `Turbo4B` (default), `balanced_9b` e `cpu_fallback`, ajustáveis por variáveis de ambiente. - **Baixa e valida** o runtime llama.cpp `b8358` (CPU ou CUDA 12.4, com SHA-256) quando ele não é encontrado. - **Opera** pela CLI `localllm`: `status`, `models`, `auth`, `config`, `bench`, `logs` e `doctor`. - **Gerencia** o runtime no app desktop (modo `local` ou `remote`; estados `stopped`, `starting`, `ready`, `degraded`, `stopping` e `error`). - **Escaneia, importa, busca e baixa** modelos do Hugging Face com progresso e cancelamento (token opcional) e troca o modelo carregado com um clique (*hot-swap*). - **Conversa** com streaming, memória opcional de até 20 mensagens, separação de `…`, contagem de tokens, tokens/s e edição, reenvio e exclusão de mensagens. - **Protege** a API com chave opcional (`LOCALLLM_API_KEY`), CORS configurável e aliases de modelo. ## 🖼️ Demonstração Capturas do shell do app com a API local offline e nenhum modelo selecionado: mostram o layout, não uma inferência em andamento.

Shell do app ForgeLM em desktop: Runtime Manager, lista de conversas e área de chat

Shell do app ForgeLM em tablet Shell do app ForgeLM em tela estreita

## 🚀 Quickstart > [!WARNING] > **A API sobe aberta por padrão.** Sem `LOCALLLM_API_KEY` não há autenticação, o bind default é `0.0.0.0:8080` e o CORS libera `*`. Fora de uma máquina confiável, defina a chave e restrinja `LOCALLLM_ADDR` e `LOCALLLM_CORS_ORIGINS`. | Ferramenta | Versão mínima | |---|---| | Rust (cargo) | edition 2021; `rust-version` não declarada | | Node.js + npm (só para o app) | não declarada (sem `.nvmrc` nem `engines`) | | Modelo `.gguf` local | obrigatório | | GPU NVIDIA | opcional (variante CUDA 12.4; existe o perfil `cpu_fallback`) | **Na primeira execução o servidor baixa o llama.cpp `b8358`** de `github.com/ggml-org/llama.cpp` se não achar o runtime (`LLAMA_DLL_PATH`, binário adjacente ou vendor legado). CUDA 12.4 são dois zips (≈ 227 MB + ≈ 391 MB); CPU, um zip de ≈ 37 MB. O manifesto só lista `windows-x64`. ```bash # 1. API local (Windows cmd; em bash use `export`) set LOCALLLM_MODEL=D:\modelos\meu-modelo.gguf cargo run -p inference-server curl http://127.0.0.1:8080/health curl http://127.0.0.1:8080/v1/models curl -N http://127.0.0.1:8080/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{"model":"default","messages":[{"role":"user","content":"Diga ola"}],"stream":true}' # 2. CLI cargo run -p localllm-cli -- status cargo run -p localllm-cli -- models list # 3. App desktop cd tauri-app npm install npm run tauri dev ``` ### Variáveis de ambiente Extraídas do código e de [`docs/api/configuration.md`](docs/api/configuration.md); não há `.env.example`. O prefixo é `LOCALLLM_` (três L). | Variável | Obrigatória | Descrição | |---|---|---| | `LOCALLLM_MODEL` | Sim | Caminho do `.gguf`; sem ele o engine aborta (`model_path is empty`) | | `LOCALLLM_ADDR` | Não | Endereço de bind; default `0.0.0.0:8080` | | `LOCALLLM_MODEL_ALIASES` | Não | Aliases do modelo, separados por vírgula, expostos em `GET /v1/models` | | `LOCALLLM_PROFILE` | Não | `balanced_9b` ou `cpu_fallback`; ausente ou outro valor = `Turbo4B` | | `LOCALLLM_GPU_LAYERS` | Não | Camadas na GPU; default do perfil (999 em `Turbo4B`/`balanced_9b`, 0 em `cpu_fallback`) | | `LOCALLLM_CTX` | Não | Janela de contexto; default do perfil (4096, 2048 e 2048) | | `LOCALLLM_BATCH` | Não | `n_batch`; sem valor explícito, usa o do perfil limitado a 4096 | | `LOCALLLM_UBATCH` | Não | `n_ubatch`; default do perfil | | `LOCALLLM_THREADS` | Não | Threads de geração; default do perfil | | `LOCALLLM_THREADS_BATCH` | Não | Threads de prefill; default do perfil | | `LOCALLLM_API_KEY` | Não | Habilita autenticação por chave; vazia ou ausente = API aberta | | `LOCALLLM_AUTH_HEADER` | Não | Cabeçalho preferencial da chave; default `authorization` (também aceita `x-api-key`) | | `LOCALLLM_AUTH_SCHEME` | Não | Prefixo removido antes da comparação (ex.: `Bearer`) | | `LOCALLLM_CORS_ORIGINS` | Não | Allowlist de origens separadas por vírgula; default `*` | | `LOCALLLM_SYSTEM_PROMPT` | Não | Prompt de sistema usado quando a request não traz `system` nem `developer` | | `LOCALLLM_ENABLE_TOOL_CALLS` | Não | Liga/desliga tool calling; default ligado | | `LOCALLLM_LOG_FORMAT` | Não | `json` para logs estruturados; default `pretty` | | `LLAMA_DLL_PATH` | Não | Caminho completo do `llama.dll`; sobrepõe a resolução automática do runtime | | `RUST_LOG` | Não | Filtro de logs do `tracing`; default `info` | A pasta de modelos **não** é variável de ambiente: na CLI é a flag global `--models-dir` (default `./models`); no app é o campo `models_dir` da configuração do runtime. Ao iniciar o servidor local, o app define `LOCALLLM_MODEL`, `LOCALLLM_ADDR`, `LOCALLLM_GPU_LAYERS` e `LOCALLLM_CTX`. ## 🧱 Arquitetura ```mermaid flowchart LR UI["App Tauri (React + Rust)"] -->|"HTTP e SSE"| SRV["inference-server (Axum)"] CLI["localllm-cli"] -->|"HTTP"| SRV SRV --> CORE["inference-core (engine, sessão, perfis)"] CORE --> SYS["llama-sys (llama.dll via libloading)"] SRV --> DEPS["runtime-deps (download + SHA-256)"] DEPS -->|"llama.cpp b8358"| SYS UI -->|"busca e download de .gguf"| HF["Hugging Face"] ``` - O app (no modo `local`) inicia e para o `inference-server` e usa `GET /health` para saber se está pronto; no modo `remote` apenas fala com a API. - A CLI é um cliente HTTP da mesma API. - O `inference-server` valida a request (auth, CORS, aliases) e delega ao `inference-core`, que mantém o engine, a sessão e o sampler. - O `inference-core` usa o `llama-sys`, que carrega `llama.dll` dinamicamente; o `runtime-deps` resolve ou baixa esse runtime a partir de [`vendor/llama-runtime/manifest.json`](vendor/llama-runtime/manifest.json). - O app busca e baixa modelos direto do Hugging Face, sem passar pela API local. ## 🗂️ Estrutura ```text crates/ api-contracts/ tipos compartilhados (chat, modelos, health, erros) inference-core/ engine de inferência, sessão, sampler e perfis inference-server/ API HTTP em Axum (binário localllm) llama-sys/ carga dinâmica do llama.cpp (libloading) metrics/ contadores de tokens e throughput runtime-deps/ resolve e baixa o runtime llama.cpp localllm-cli/ CLI (binário localllm) tauri-app/ app desktop: React 18 + Vite + Tailwind, backend Tauri 2 ui/ páginas HTML estáticas de desenvolvimento (index.html, chat.html) docs/ documentação detalhada ``` ## 🧪 Scripts | Comando | O que faz | |---|---| | `cargo run -p inference-server` | Sobe a API em `0.0.0.0:8080` (exige `LOCALLLM_MODEL`) | | `cargo run -p localllm-cli -- ` | Executa a CLI | | `cargo test` | Testes dos crates do workspace | | `cargo test --manifest-path tauri-app/src-tauri/Cargo.toml` | Testes do backend Tauri (fora do workspace) | | `npm run dev` (em `tauri-app`) | Só o frontend, Vite na porta 1420 | | `npm run tauri dev` | App desktop completo | | `npm run build` | `tsc && vite build` | | `npm run preview` | `vite preview` | | `npm test` | `vitest run` | | `npm run tauri` | Repassa argumentos ao `tauri` CLI | | `scripts/build-dev.sh` (há `.ps1`) | Compila `vendor/llama.cpp` em Debug com CUDA | | `scripts/build-prod.sh` (há `.ps1`) | Compila `vendor/llama.cpp` em Release com LTO e CUDA (arch 86) | ## 📚 Documentação | Documento | Conteúdo | |---|---| | [`docs/README.md`](docs/README.md) | Índice da documentação | | [`docs/api/overview.md`](docs/api/overview.md) · [`endpoints.md`](docs/api/endpoints.md) · [`configuration.md`](docs/api/configuration.md) | API: visão geral, endpoints e configuração | | [`docs/cli/overview.md`](docs/cli/overview.md) · [`commands.md`](docs/cli/commands.md) | CLI: visão geral e comandos | | [`docs/app/overview.md`](docs/app/overview.md) · [`user-guide.md`](docs/app/user-guide.md) · [`backend-commands.md`](docs/app/backend-commands.md) | App: visão geral, guia de uso e comandos Tauri | | [`docs/developer/architecture.md`](docs/developer/architecture.md) | Mapa do workspace e fluxos entre módulos | | [`.planning/ROADMAP.md`](.planning/ROADMAP.md) | Fases e estado do desenvolvimento | ## 🛣️ Limitações e próximos passos - A API expõe só três endpoints; a compatibilidade com a OpenAI é parcial: `n` precisa ser `1`, `parallel_tool_calls` não é recurso suportado e `content` em partes vira texto consolidado. - O raciocínio não é um campo separado na API; quem separa `…` é o frontend do app. - Na CLI, a execução ao vivo está mais consolidada em `status`, `models list` e `bench throughput`; o resto da superfície está mais avançado no parser do que nas capacidades HTTP públicas. - O chat usa `sql.js` carregado por CDN e persiste o banco exportado em `localStorage`; não é um banco nativo do sistema. - No modo local o app precisa encontrar o binário `localllm`, e o runtime manager faz polling do snapshot (sem eventos push). - O manifesto do runtime só lista variantes `windows-x64`; em outros alvos o servidor só sobe com um runtime já presente (binário adjacente ou `LLAMA_DLL_PATH`). - `scripts/build-dev.sh` e `scripts/build-prod.sh` exigem o submódulo `vendor/llama.cpp`, que não está declarado no repositório (não há `.gitmodules`). - `inference-server` e `localllm-cli` declaram ambos um binário chamado `localllm`; use `cargo run -p ` para escolher. - Próximos passos registrados no roadmap: concluir a fase 5 (validação de fontes de modelo, com seus três planos marcados como feitos mas a fase ainda aberta) e a fase 6 (redesign do chat e da página de Configurações, 0/3 planos). ## 🤝 Contribuindo Abra uma issue ou PR descrevendo a mudança. Antes de enviar, rode os testes que cobrem o que você alterou: ```bash cargo test && (cd tauri-app && npm test) ``` ## 📄 Licença MIT, declarada em [`Cargo.toml`](Cargo.toml); o repositório não inclui arquivo `LICENSE`. Os binários de inferência vêm do [llama.cpp](https://github.com/ggml-org/llama.cpp) e os modelos do [Hugging Face](https://huggingface.co) seguem a licença de cada autor.