
[Início rápido](#in%C3%ADcio-r%C3%A1pido) · [Documentação](docs/README.md) · [Issues](https://git.evandro.dev.br/evandro/ForgeLM/issues)
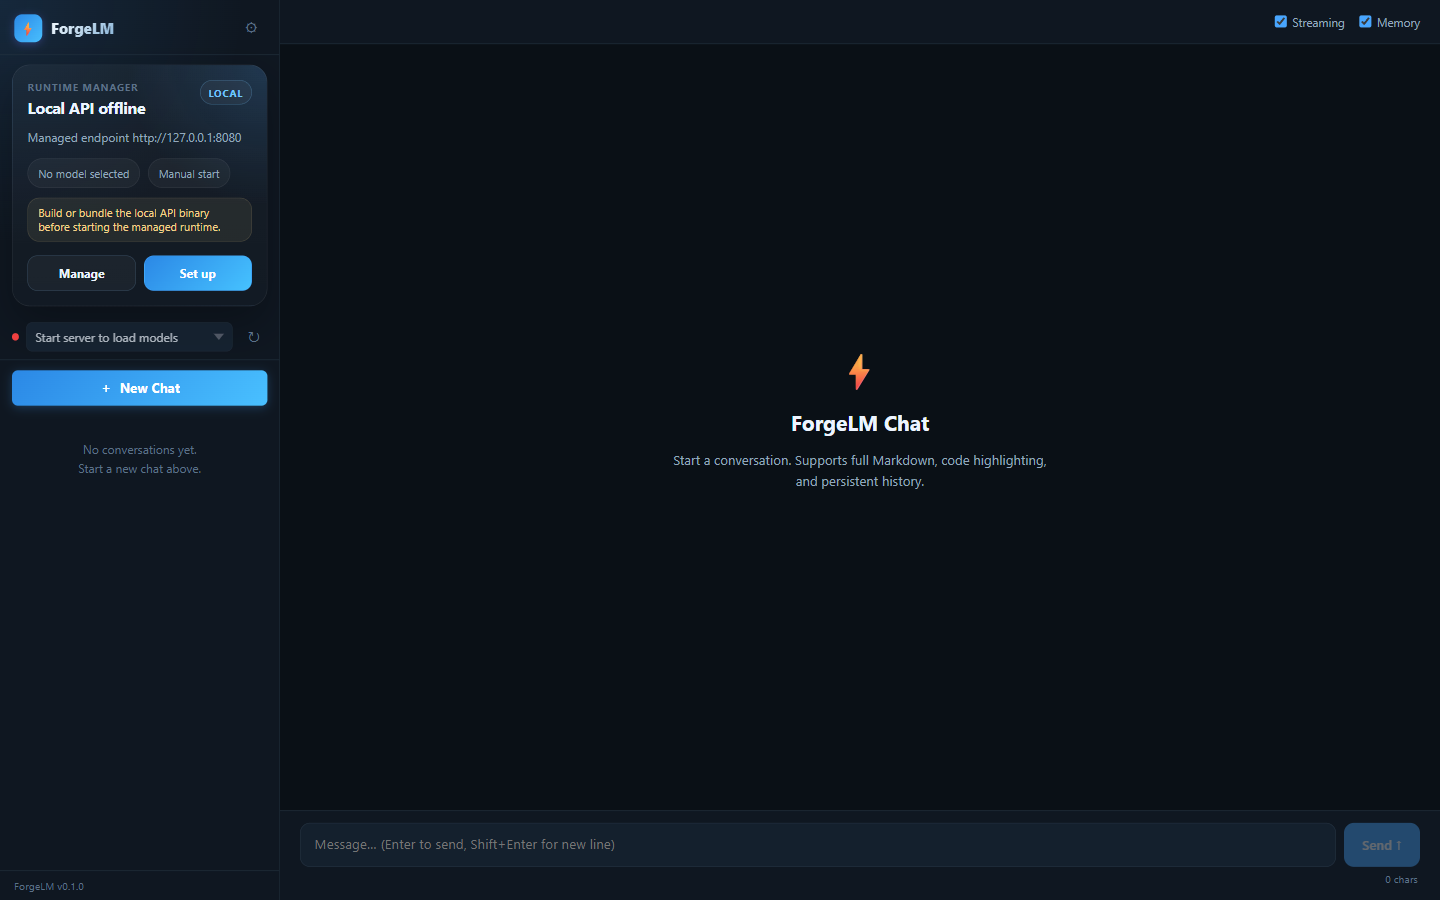
Captura do import inicial (março de 2026), com a API local parada. A interface mudou depois: o seletor de modelo foi para a caixa de mensagem.
## O que é
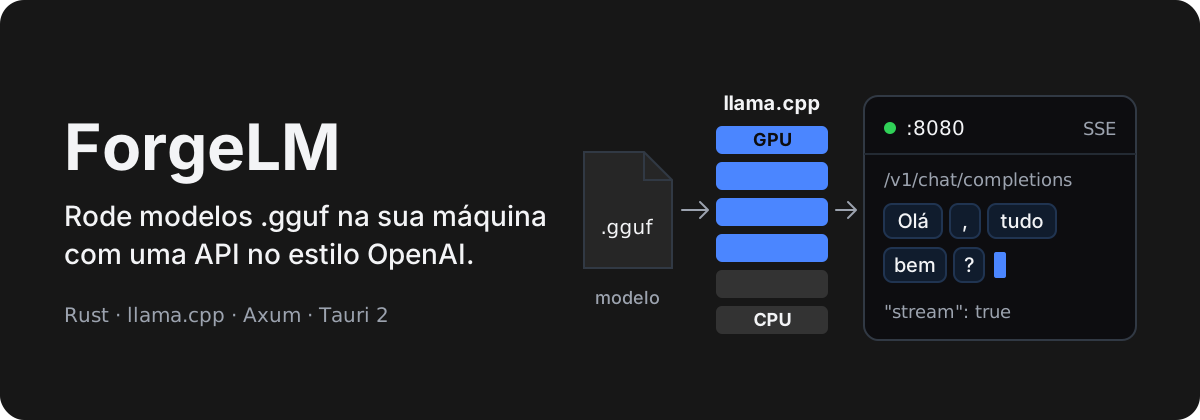
O ForgeLM roda modelos `.gguf` na sua máquina com o [llama.cpp](https://github.com/ggml-org/llama.cpp) e os expõe numa API HTTP no estilo OpenAI, com streaming SSE. O mesmo workspace Rust traz uma CLI (`localllm`) e um app desktop em Tauri que liga o servidor, busca e baixa modelos do [Hugging Face](https://huggingface.co) e conversa com eles.
## Por que usar
- **Uma peça só, local.** Servidor, engine, download do runtime e app vivem num workspace Rust. Na primeira execução o servidor baixa o llama.cpp `b8358` (CPU ou CUDA 12.4) do GitHub e confere o SHA-256, se não achar um runtime já instalado.
- **Clientes OpenAI funcionam com poucas mudanças.** `GET /v1/models` e `POST /v1/chat/completions` seguem o formato da OpenAI; basta trocar a URL base.
- **Perfis prontos.** `Turbo4B` (padrão), `balanced_9b` e `cpu_fallback` definem camadas na GPU, contexto e threads, e cada valor pode ser sobrescrito por variável de ambiente.
**Quando não usar:** se você precisa de compatibilidade ampla com a OpenAI (são três endpoints, `n` precisa ser `1`, sem embeddings), de download automático do runtime fora do Windows x64, ou de algo estável. Nesses casos, o servidor do próprio llama.cpp atende melhor.
## Como funciona
- `inference-server` (binário `localllm`): API em Axum na porta `8080`. Valida autenticação, CORS e aliases e repassa ao `inference-core`.
- `inference-core`: engine, sessão, sampler e perfis, sobre o `llama-sys`, que carrega o `llama.dll` em tempo de execução.
- `runtime-deps`: acha ou baixa o runtime descrito em [`vendor/llama-runtime/manifest.json`](vendor/llama-runtime/manifest.json).
- `localllm-cli`: cliente HTTP da mesma API, com `status`, `models`, `auth`, `config`, `bench`, `logs` e `doctor`.
- `tauri-app`: React 18 + Vite + Tailwind com backend Tauri 2. No modo `local` inicia e para o servidor e consulta `GET /health`; no modo `remote` só fala com a API. A busca de modelos no Hugging Face não passa pela API local.
Detalhes em [`docs/developer/architecture.md`](docs/developer/architecture.md).
## Início rápido
> [!WARNING]
> **A API sobe aberta por padrão.** Sem `LOCALLLM_API_KEY` não há autenticação, o bind padrão é `0.0.0.0:8080` e o CORS libera `*`. Fora de uma máquina confiável, defina a chave e restrinja `LOCALLLM_ADDR` e `LOCALLLM_CORS_ORIGINS`.
Requisitos: Rust (cargo; o projeto não declara `rust-version`), um modelo `.gguf` local e, só para o app, Node.js com npm (sem versão declarada). GPU NVIDIA é opcional: o perfil `cpu_fallback` roda sem ela.
Na primeira execução, o download do runtime tem cerca de 37 MB na variante CPU e cerca de 618 MB na CUDA 12.4 (dois zips). O manifesto só lista `windows-x64`; em outros sistemas, aponte `LLAMA_DLL_PATH` para uma biblioteca já instalada.
```bash
# 1. API local (bash; no cmd do Windows, use set no lugar de export)
export LOCALLLM_MODEL=/caminho/para/meu-modelo.gguf
cargo run -p inference-server
curl http://127.0.0.1:8080/health
curl http://127.0.0.1:8080/v1/models
curl -N http://127.0.0.1:8080/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{"model":"default","messages":[{"role":"user","content":"Diga olá"}],"stream":true}'
# 2. CLI
cargo run -p localllm-cli -- status
cargo run -p localllm-cli -- models list
# 3. App desktop
cd tauri-app
npm install
npm run tauri dev
```
Testes: `cargo test` (crates do workspace), `cargo test --manifest-path tauri-app/src-tauri/Cargo.toml` (backend Tauri, fora do workspace) e `npm test` em `tauri-app` (Vitest).
## Configuração
A API lê tudo de variáveis de ambiente; não há `.env.example`. A pasta de modelos não é variável: na CLI é a flag global `--models-dir` (padrão `./models`), no app é o campo `models_dir` da configuração do runtime. Ao iniciar o servidor local, o app define `LOCALLLM_MODEL`, `LOCALLLM_ADDR`, `LOCALLLM_GPU_LAYERS` e `LOCALLLM_CTX` (contexto padrão do app: 4096).
Variáveis de ambiente da API
| Variável | Obrigatória | Descrição |
|---|---|---|
| `LOCALLLM_MODEL` | Sim | Caminho do `.gguf`; sem ela o engine aborta (`model_path is empty`) |
| `LOCALLLM_ADDR` | Não | Endereço de bind; padrão `0.0.0.0:8080` |
| `LOCALLLM_MODEL_ALIASES` | Não | Aliases do modelo, separados por vírgula, expostos em `GET /v1/models` |
| `LOCALLLM_PROFILE` | Não | `balanced_9b` ou `cpu_fallback`; ausente ou outro valor = `Turbo4B` |
| `LOCALLLM_GPU_LAYERS` | Não | Camadas na GPU; padrão do perfil (999 em `Turbo4B` e `balanced_9b`, 0 em `cpu_fallback`) |
| `LOCALLLM_CTX` | Não | Janela de contexto; padrão do perfil (131072, 65536 e 16384) |
| `LOCALLLM_BATCH` | Não | `n_batch`; sem valor explícito, usa o do perfil limitado a 4096 |
| `LOCALLLM_UBATCH` | Não | `n_ubatch`; padrão do perfil |
| `LOCALLLM_THREADS` | Não | Threads de geração; padrão do perfil |
| `LOCALLLM_THREADS_BATCH` | Não | Threads de prefill; padrão do perfil |
| `LOCALLLM_API_KEY` | Não | Liga a autenticação por chave; vazia ou ausente = API aberta |
| `LOCALLLM_AUTH_HEADER` | Não | Cabeçalho preferencial da chave; padrão `authorization` (também aceita `x-api-key`) |
| `LOCALLLM_AUTH_SCHEME` | Não | Prefixo removido antes da comparação (ex.: `Bearer`) |
| `LOCALLLM_CORS_ORIGINS` | Não | Origens permitidas, separadas por vírgula; padrão `*` |
| `LOCALLLM_SYSTEM_PROMPT` | Não | Prompt de sistema usado quando a request não traz `system` nem `developer` |
| `LOCALLLM_ENABLE_TOOL_CALLS` | Não | Liga ou desliga tool calling; padrão ligado |
| `LOCALLLM_LOG_FORMAT` | Não | `json` para logs estruturados; padrão `pretty` |
| `LLAMA_DLL_PATH` | Não | Caminho completo da biblioteca do llama.cpp; sobrepõe a resolução automática |
| `RUST_LOG` | Não | Filtro de logs do `tracing`; padrão `info` |
## Estado do projeto
Em desenvolvimento. Pelo [`.planning/ROADMAP.md`](.planning/ROADMAP.md), as fases 1 a 4 estão concluídas, a fase 5 (validação de fontes de modelo) segue aberta com os três planos marcados e a fase 6 (redesign do chat e das Configurações) tem 0 de 3 planos.
- A compatibilidade com a OpenAI é parcial: `parallel_tool_calls` não é recurso suportado, `content` em partes vira texto e o raciocínio não sai num campo separado (quem separa `…` é o app).
- O chat do app usa `sql.js` carregado por CDN e guarda o banco no `localStorage`.
- `scripts/build-dev.sh` e `scripts/build-prod.sh` (e as versões `.ps1`) exigem `vendor/llama.cpp`, que não está no repositório.
- `inference-server` e `localllm-cli` declaram um binário com o mesmo nome, `localllm`; use `cargo run -p `.
Para contribuir, abra uma issue ou um PR e rode os testes da parte que você alterou.
## Licença
Sem licença publicada: todos os direitos reservados. O [`Cargo.toml`](Cargo.toml) declara `license = "MIT"`, mas o repositório não inclui o arquivo `LICENSE`. Os binários do llama.cpp e os modelos do Hugging Face seguem a licença de cada autor.